前言:为什么这个秋天要重新认识李飞飞#
2026 年的夏天到秋天,李飞飞的曝光密度有点罕见:8 月做客神经科学播客 Huberman Lab 聊了两个小时「AI 到底缺什么」;9 月带着 World Labs 的新世界模型 Atlas 上了一档 a16z Show 深度技术对谈;更早的 6 月,她和 MasterClass 创始人 David Rogier 一起在 Silicon Valley Girl 节目里聊「十年后的职场」;8 月底还接受了 Bloomberg 的视频专访,公开批评硅谷的「上帝情结」。
四场访谈对象不同、话题各异,但拼在一起,恰好是一张完整的地图:AI 从哪里来、现在缺什么、下一步去哪、普通人该怎么办。这篇文章把这四场对谈的干货拆出来,尽量保留她的原话。
李飞飞,斯坦福大学教授,ImageNet 数据集发起人——2012 年正是「大数据集 + 深度神经网络 + GPU」三要素在她攒出的数据集上碰头,才点燃了这一轮 AI 浪潮。2024 年创立 World Labs,押注「空间智能(Spatial Intelligence)」。
四场访谈时间线#
| 时间 | 访谈 / 节目 | 主题 |
|---|---|---|
| 2026-06-19 | Silicon Valley Girl(主持人 Marina Mogilko) | AI 时代的职场与个人竞争力 |
| 2026-08 上旬 | Huberman Lab(主持人 Andrew Huberman,约 2 小时) | 视觉、智能、AI 的能力边界与教育 |
| 2026-08 下旬 | Bloomberg 视频专访 | AI 政策、硅谷「上帝情结」 |
| 2026-09 初 | a16z Show(主持人 Martin Casado) | 世界模型 Atlas 与空间智能 |
一、视觉是智能的基石:5.4 亿年前的伏笔#
Huberman Lab 那期对话从「视觉」切入——这几乎是李飞飞的母题。她给出了一个很有画面感的开场:
5.4 亿年前,远古海洋生物第一次「看见」光。感光细胞的出现,直接催生了寒武纪物种大爆发。对人类而言,大脑皮层一半的神经活动都与视觉相关——婴幼儿也是先学会「看」,再学会「说」。
对 AI 来说,视觉的贡献有两个:提供算法灵感(上世纪 50 年代科学家发现哺乳动物视觉系统的层级神经结构,直接启发了早期神经网络设计)和促进数据觉醒。谈到后者,她回忆了 2006 年在普林斯顿做研究时的转折:
当时算法效果始终不理想,我意识到卡住脖子的可能不是算法,而是训练数据太少了。一个孩子到 6 岁能认出几万样东西,靠的是成长过程中看过的海量画面。所以我们不再死磕算法,转而发起 ImageNet,攒出了千万级的图片数据集。
2012 年之后发生的事大家都知道了。她补充了一个细节:人类分辨一千种物品的错误率大约只有 4%,而算法直到 2016 年才第一次超过人类——语音、听觉方向后来的发展路径,和图像识别几乎一模一样,Transformer 出来后五年迭代,才有了 2022 年的 ChatGPT。
二、AI 到底缺什么:它读得到全网,读不到你#
这是整场 Huberman 访谈里我认为最有营养的部分。主持人问:AI 能让静态图动起来、能写诗,那它到底还缺什么?李飞飞给了一个两层答案。
第一层:AI 的学习逻辑和人脑是两码事。 小孩子只见过几只猫,就能举一反三认出所有猫;AI 得刷完网上几乎所有猫咪图片,靠统计规律去分辨。「两者的学习逻辑天差地别,背后还有一大堆待破解的科学难题。」
第二层:人类最私密的那部分体验,AI 根本没有数据可学。
互联网汇集了人类的图文、影像,这是 AI 强大的根本。但那些高度私人化的思绪、情绪与心底的感触,没有任何形式的记录,网上找不到相关数据,AI 没办法学习和体会。
她拿 AlphaGo 的第 37 手举例:看着像创造力,但围棋有一套完整严谨的数学规则;而真正的顶尖数学难题,需要人类跳出固有框架想出全新解法——这类问题她更看好人和 AI 协作攻克。至于看到一只杯子瞬间勾起的、只属于自己的童年往事,「这种私人又主观的情感体验,是现阶段 AI 完全触碰不到的局限」。
由此她给了一个金句式的结论:
无论是在医疗、影视还是教育领域,AI 都不是人类的替代者,而是个人能力的放大镜。
医疗是她最看好的落地场景。 访谈里她讲了一件私事:她父亲不久前在斯坦福做了肝脏手术,由外科主刀医生全程操控达芬奇手术机器人完成,术后出血量比传统手术少了十倍。她问主刀医生:汇总全球所有肝脏手术数据,能不能训练出一台全自动手术 AI?答案并不乐观——肝脏血管分布密集、每个人器官形态差异极大,数据量很难支撑算法达到稳定可靠。她的总结很清醒:
AI 的判断全部依托数据里的规律,一旦对应场景的样本稀少,我们就要理性看待它的能力边界。复杂手术里,医生操控机器人远比机器人自主执刀好——这正是人机协作可以大放异彩的地方。
而像鉴别诊断(比如区分眩晕症和低血压)这种积累了海量病例的场景,AI 就能充分发挥作用,给没法及时就医的人提供初步参考。
三、空间智能与 Atlas:预测一个「没有被拍下」的世界#
如果说 Huberman 那期是「科普向」,9 月初的 a16z Show 就是「技术向」。World Labs 联合创始人李飞飞、Justin Johnson 和 Ben Mildenhall 三人一起聊了新产品 Atlas——一款多模态世界模型。
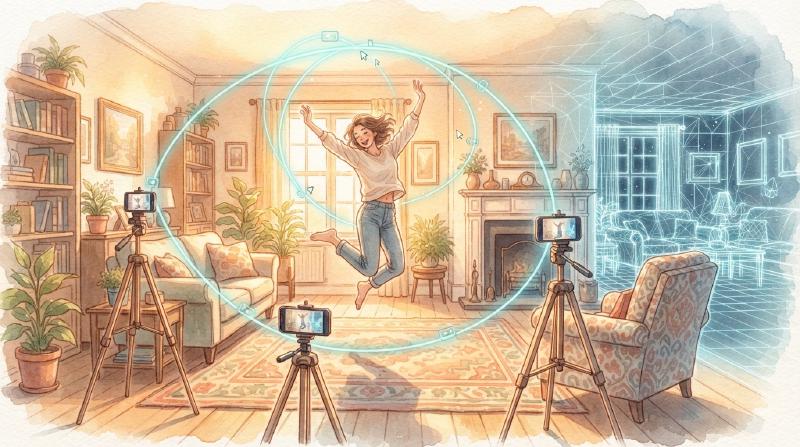
演示里最抓眼球的一个能力:只用三部固定在三脚架上的 iPhone,Atlas 就能重现《黑客帝国》式的「子弹时间」,让镜头绕着凝固的动作移动。
李飞飞团队把 Atlas 的核心能力称为「新视角预测」:区别于一般视频模型沿时间轴预测下一帧,Atlas 是根据已有画面和相机位姿,判断「镜头移动到另一个时空位置后会看到什么」。她 Stanford 校园演示时的一个例子很传神——模型只收到 3 到 25 张从地面拍的照片,却生成了校园上空的俯瞰画面:
空中视角并非来自原始素材,而是在已知空间关系约束下生成的结果。
几个技术要点值得记下:
- 传统三维重建要求每处表面至少出现在 3-4 个视角里,拍一个房间可能需要 100-300 张照片;Atlas 有望降到约 3 张,相当于减少 50-100 倍。
- 上一代模型 Marble 以高斯泼溅表示三维场景,所有输出都得先落到这一种表示上,限制很多;Atlas 把「新视角预测」放到更基础的位置,高斯泼溅变成按需调用的输出形式之一。
- 团队还回忆了一个关键验证时刻:2026 年初夏,一个早期模型处理 NeRF 经典的花园桌场景后,给出了此前从未拍过的桌下视角——画面里还出现了一只足球。正是这次验证,让三位创始人决定押注这个方向。
为什么执着于空间智能?她的回答一贯宏大而具体:
生成具有空间语境和现实依据的像素,是通往空间智能的一步。空间智能最终需要支持生成、推理、编辑和交互。
而商业化落地上,她把重心放在了机器人:2026 年 7 月,World Labs 收购机器人公司 SceniX,补上了「现实环境重建 → 模拟训练 → 现实部署」的技术链。她认为机器人当前的主要瓶颈是数据——线缆的弯曲方式、容器的尺寸和颜色、物体的摆放位置都可能变化,模拟环境能快速生成这些「难以逐一采集的训练情形」。团队甚至在探索「神经模拟器」:不再只靠人工编写规则的传统物理引擎,而是让模型从数据里学习环境面对动作时可能发生的变化。
至于 AGI 的时间表,她 6 月在另一场访谈里给过一个克制的判断:空间智能的前路「可能不需要 50 年,但也绝不止 1 年」。
四、十年后的职场:杠铃效应,危险的是中间#
6 月的 Silicon Valley Girl 访谈传播最广,但也是被标题党歪曲最狠的一期——「李飞飞预言 10 年后只剩两类人能找到工作」并不准确。实际情况是:MasterClass 创始人 David Rogier 提出了一个「杠铃效应(Barbell Effect)」的猜想,李飞飞认可了其中部分判断,并进一步强调了 agency(主动性)。
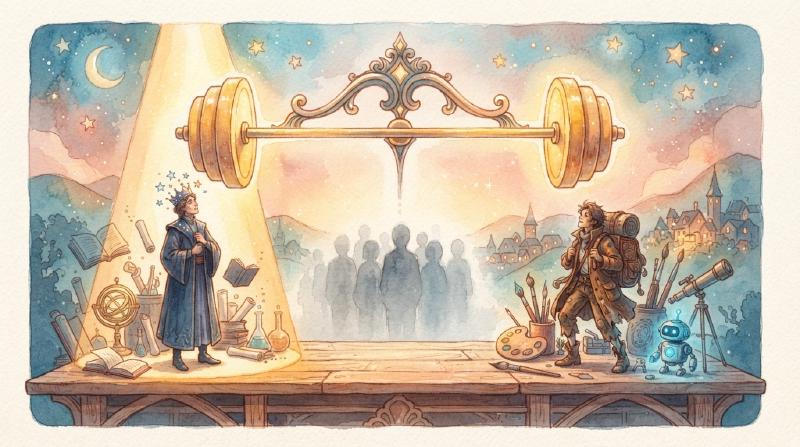
杠铃的两端:
- Top 1% 的深度专家(Deep Specialist):普通文案能力已经容易被 AI 商品化——一个普通人借助大模型就能写出「还不错」的文案。但如果你是某个领域最顶尖的 1%,AI 反而会成为你的超级杠杆。
- 高主动性多面手(High-Agency Generalist):未必在某个领域世界第一,但特点是「主动发现问题 → 主动学习 → 找工具 → 使用 AI → 组合资源 → 把事情做出来」,一个人能完成以前 5-10 人团队的一部分工作。Rogier 自己就是例子——他用 Claude Code 给自己造工作工具,而不是买现成软件。
真正危险的是中间层:工作内容高度标准化、专业能力又没有形成明显差异化的人。普通信息整理、普通文案、基础分析、基础代码、标准化 research——恰恰都是生成式 AI 提效最猛的区域。
更精彩的是李飞飞对流行叙事的反驳。主持人提了一个流传很广的说法:「工业革命自动化了体力劳动,AI 革命要自动化智力劳动。」她不完全认同:
工业革命并不是简单地把「劳动」自动化,而是提高劳动效率、扩大生产规模,同时改变劳动市场和劳动形式。而且体力劳动本身就包含大量智能。
所以「AI 会不会取代我的工作」可能是个问错了的问题,更好的问法是:AI 会把哪些技能从稀缺能力变成普通能力? 想清楚这一点,就知道该往杠铃的哪一端走。
五、教育与下一代:苏格拉底是人类历史上最好的「提示工程师」#
几场访谈里,李飞飞谈教育谈得格外动情——她自己就是教育者,孩子也在上学的年纪。
关于孩子用 AI,她认为有两个都要警惕的极端:
- 过度依赖:无休止刷短视频、被动接收信息流,会一点点消磨主观能动性。「学习的内生动力、自主思考的能力,不能被任何人、任何机器剥夺。如果滥用 AI 消磨掉孩子的能动性,下一代的大脑就没法得到充分发育。」
- 一刀切封禁:因为担心作弊就全面禁止学生接触 AI,同样不可取。她回忆自己读本科时想吃透有机化学分子的空间结构,但助教答疑时间短、还总冲突——「如果当年有 AI 学习助手,我就能针对自己卡壳的知识点反复提问。只要自身有求知的意愿,AI 就是极强的辅助工具,我们不该剥夺学生拥有这种助力的机会。」
关于提问能力,她给出了整组访谈里流传最广的一个说法:
人类历史上最顶尖的「提示工程师」是谁?是苏格拉底。他标志性的诘问法,本质就是层层递进、不断追问,顺着线索挖掘事物本质。这套思维方式,完全可以教给孩子们。
她最放心不下的,其实是一线老师和家长。 2022 年 ChatGPT 刚上线时,她第一时间给孩子的小学校长发邮件,主动提出入校给老师和学生做分享——「硅谷的投资人、千亿市值的科技巨头,几乎没有人第一时间想到周边学校的授课老师,但这件事恰恰至关重要。」她反复说:
想要守护下一代,一定要看见教师群体,帮扶老师与家长,才能真正引导青少年正确使用 AI。
六、治理与「上帝情结」:不能让少数公司替全社会做决定#
Bloomberg 专访里,李飞飞罕见地直接批评了硅谷精英心态。主持人用「god complex(上帝情结)」来概括,她顺势展开:
未来的生活图景,不该由某一家企业、一群投资人单方面定义,全社会都该主动参与、一起构想。现在关于 AI 的舆论有个很大的问题:普通人永远只能被动接受技术带来的结果,却没办法参与前期的设计规划。
她提到给各国领导人提 AI 政策建议时有一条底线原则:Science, not politics(基于科学,而非政治)。在 Huberman 访谈里她也给出了具体的治理思路:AI 行业可以参考汽车、生物科技的过往经验——制定行业伦理准则、在高校开 AI 伦理课程、医疗这类高风险应用由类似 FDA 的权威机构划安全红线。「不能只让少数科技企业替整个社会做决定,追逐市场收益的逻辑,绝不能凌驾于社会伦理与大众文化之上。」
她也对公共舆论的两极分化表达了担忧:一部分人忙着散播末日恐慌,另一部分人忙着鼓吹技术无所不能。「两种声音都太极端了。我们需要回归客观中立的视角,让全社会一起掌握塑造未来的主动权。」这也是她创办斯坦福 HAI(以人为本人工智能研究院)的初衷。
七、给普通人的五条启示#
把四场访谈放在一起,我提炼出五条普通人用得上的结论:
- 把 AI 当放大镜,别当替身。 让它放大你的专业与表达,而不是替你交差——被替代的从来不是「人」,而是「没有差异化的工作内容」。
- 往杠铃的一端走。 要么在某个领域扎到前 1%,要么成为「给我一个问题,我能用 AI 把它解决掉」的高主动性多面手。最危险的是中间的标准化地带。
- 练提问,就是练思考。 苏格拉底式的层层追问,是这个时代性价比最高的自我训练。
- 别高估短期,别低估长期。 空间智能「不需要 50 年,但绝不止 1 年」——用这种节奏感安排自己的学习,既不焦虑也不躺平。
- 对技术的态度:理性审慎。 机遇和阵痛同时存在,末日论和乌托邦都不值得订阅。
参考资料#
- 量子位:《李飞飞最新访谈:AI 咋能代替人呢?》(Huberman Lab 访谈中文精校)— https://www.qbitai.com/2026/08/474140.html
- Huberman Lab 英文全文实录 — https://singjupost.com/transcript-of-dr-fei-fei-li-interview-on-huberman-lab/
- DeepTech/知乎:《发布 Atlas 后,李飞飞最新访谈:如何预测一个未被拍下的世界》(a16z Show 中文整理)— https://zhuanlan.zhihu.com/p/2080642659710939733
- Data Application Lab:《AI 教母李飞飞访谈,10 年后只有两类人能找到工作》(Silicon Valley Girl 访谈整理)— https://www.dataapplab.com/only-two-kinds-of-people-will-have-jobs-in-10-years/
- Bloomberg 视频专访(2026-08)— Bloomberg Business 官方账号